AI 的碳排放問題,比誰說的都嚴重
訓練一個 AI 模型產生的碳排放,已經超過某些國家一整年的產出。斯坦福 2026 AI 指數揭示算力軍備競賽的環境代價。
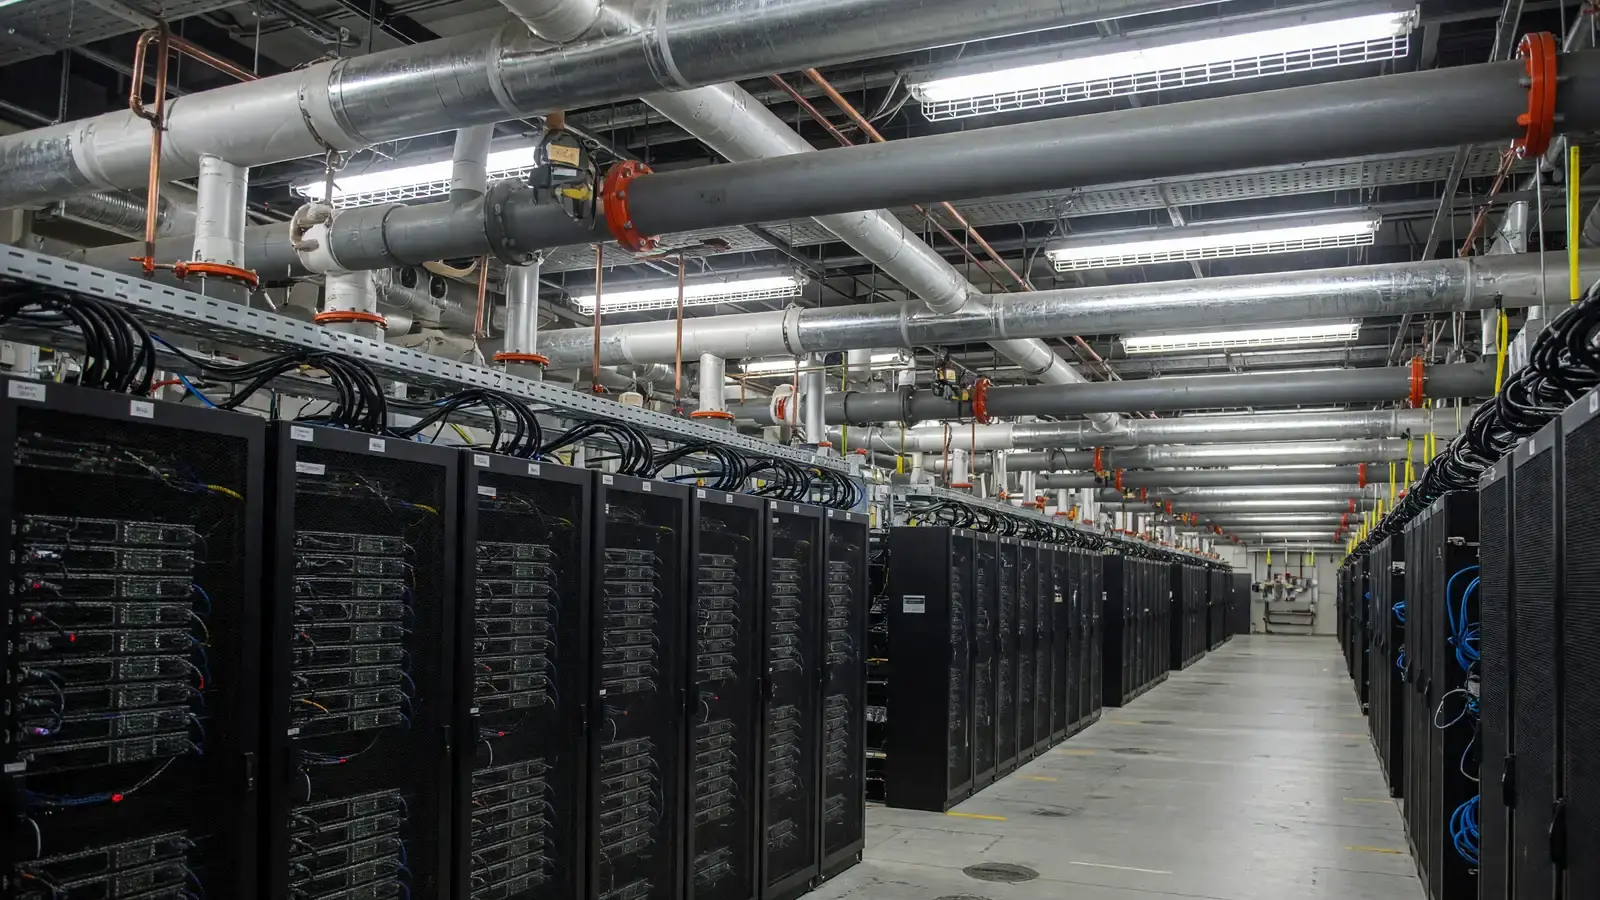
AI 產業正在以讓華爾街和環境科學家都感到不安的速度消耗資本和碳排放。根據斯坦福大學 2026 年 AI 指數報告,全球 AI 算力容量自 2022 年以來每年增長 3.3 倍——短短四年內翻了 30 倍。與此同時,訓練一個前沿模型產生的碳排放量已經接近某些小國一整年的排放總量。
這不是理論問題。它正在發生,而且數字令人震驚。
應該讓所有人警覺的數據
先看斯坦福 AI 指數的實際測量結果。這份報告已經連續第五年追蹤大型語言模型訓練的碳足跡,數據來自 Epoch AI 等研究機構的估算。趨勢相當不妙。
xAI 的 Grok 4 是最近一份被分析的前沿模型,訓練過程產生超過 72,000 噸二氧化碳當量排放。Epoch AI 的獨立評估更高——大約 140,000 噸。作為對比:美國人均年碳排放約 16 噸。訓練一次 Grok 4 產生的碳足跡相當於 4,500 個美國人生活一年的排放量。
數字跳得很快。2023 年發布的 GPT-4 估計產生 5,184 噸排放。2024 年的 Meta Llama 3.1 405B 達到 8,930 噸。到了 2025-2026 年的 Grok 4,數字比 GPT-4 的基準暴漲了 13 倍以上。每一代模型的訓練成本不只是略高——而是呈指數級增長。
而且這還只是訓練階段。推論——也就是實際運行這些模型來回答查詢——又疊加了一層持續累積的排放。斯坦福數據顯示,效率最低的推論模型每次查詢產生的碳排放是效率最高模型的 10 倍以上。DeepSeek V3 處理一個中等長度的提示大約消耗 23 瓦,而 Anthropic 的 Claude 4 Opus 只需要約 5 瓦。當你每天運行數百萬次查詢時,這個差距非常有意義。
為什麼算力增長比任何人預測的都快
碳排放問題的根源是更根本的問題:全球部署的 AI 算力規模之大。追蹤全球算力容量的 Epoch AI 報告,自 2021 年(他們開始系統性測量的第一年)以來,全球 AI 算力增長了 30 倍。
Nvidia 的 GPU 目前佔全球 AI 算力總容量的 60% 以上。亞馬遜和谷歌各自設計定制晶片,分列第二和第三。但整體規模還在持續擴大。大型科技公司 2026 年在 AI 基礎設施上的預計支出接近 7,000 億美元,而且看不到明確的終點。
這就形成了一個反饋循環。更多算力意味著更多訓練、更多實驗、更多模型迭代。每次迭代都消耗能源。每次能源消耗都產生排放。而市場要求這些公司不斷推進——因為在 AI 競賽中落後的後果,是董事會比碳排放賬單更在意的事情。
斯坦福 AI 指數還揭示了一個趨勢:幾乎所有值得注意的模型發布現在都來自企業界而非學術界。2025 年,美國機構發布了 50 個重要模型,中國正在快速追趕。AI 開發的工業化意味著碳成本不是分散在幾個研究實驗室——而是集中在世界上最龐大的企業中,每個企業都在競相超越對方。
ROI 斷裂讓問題更加嚴重
這就是環境成本在政策層面真正變得棘手的地方。如果 AI 在各個領域都帶來了巨大的經濟價值,那麼碳排放可能就像半導體晶圓廠或製藥一樣,可以被視為一項變革性技術的必要代價。
但普華永道 2026 年 CEO 調查報告——訪問了 95 個國家的 4,454 位首席執行官——呈現了不同的景象。超過一半——56%——表示他們的 AI 投資沒有帶來任何財務影響。不是效果打折。不是回報低於預期。是零。只有 12% 的企業——普華永道稱之為「先鋒軍」——成功利用 AI 同時實現了降低成本和增加收入。
這就形成了一個令人不安的算式。全世界正在產生數以萬噸計的 CO₂ 來訓練大多數企業根本不知道如何變現的模型。環境成本是真實且可衡量的。經濟效益,對大多數 AI 採用者來說,仍然停留在理論階段。
普華永道將根源歸結為「孤立的、戰術性的 AI 項目」——企業將 AI 開發 bolt 到現有工作流上,而不是圍繞 AI 能力重建流程。結果就是報告委婉稱之為「試點地獄」的現象——AI 被使用到足以讓人覺得在進步,但從未深入到足以創造實際成果。與此同時,碳排放持續累積。
效率提升解決不了根本問題
AI 產業應對碳排放擔憂的標準回答是指向效率提升。這確實有道理。每一代硬件的推論能耗都顯著下降。新的模型架構用更少的參數實現相似能力。量化技術讓模型能在更低端的硬件上運行。
但效率提升正在與規模擴大進行一場必輸的戰鬥。即使每次查詢的運行成本降低 10 倍,查詢總量的增長速度更快。光是 ChatGPT 每月就處理數十億次請求。谷歌搜索、微軟 Office 或蘋果生態系統中每增加一個 AI 功能,都會倍增推論負載。
斯坦福 AI 指數的推論排放數據能說明問題。Claude 4 Opus 每次中等長度提示消耗 5 瓦,但 AI 交互數量持續增長,總推論排放量不管單次查詢效率怎麼改都在往上走。這是傑文斯悖論在 AI 領域的翻版:讓某樣東西更有效率,往往增加的是總消耗量而非減少。
還有地理維度。驅動 AI 工作負載的數據中心集中在特定區域,通常依賴可能仍然嚴重依賴化石燃料的本地電網。AI 算力的碳強度取決於服務器的物理位置和使用的能源來源,差異巨大。
監管真空
環境法規尚未跟上 AI 碳足跡的步伐。傳統的環境報告框架——比如美國證交會的氣候披露規則或歐盟的企業可持續發展報告指令——並非為 AI 算力排放的獨特特性而設計。
訓練一個前沿模型涉及跨數千個 GPU 的分散式計算,通常分佈在多個不同司法管轄區的數據中心。一次訓練運行的碳足跡可能橫跨德州的能源供應商、北歐的散熱系統,以及台灣晶片製造的生產排放。沒有任何單一監管機構能完整捕捉全貌。
部分司法管轄區已開始回應。美國一些地方政府已經開始限制或直接禁止某些地區新建數據中心,理由是能源消耗和環境影響。但這些只是對系統性問題的零散應對。
歐盟的 AI 法案涵蓋了 AI 治理的許多方面,但並未直接處理環境外部性。目前沒有類似於汽車油耗標準的 AI 算力標準,也沒有專門針對訓練或推論能源成本的碳稅。
有意義的行動應該是什麼樣子
解決 AI 碳排放問題需要多層面的介入。在模型開發階段,對訓練算力和排放的透明披露——類似食品營養標籤——能讓市場和監管機構評估前沿模型的真實成本。
在基礎設施層面,數據中心對可再生能源的採購承諾是必要但不夠的。問題不只是電力從哪裡來——而是消耗的總量。即使一個完全使用風能的數據中心,也佔用了原本可用於其他用途的可再生能源。
在產業層面,當前的軍備競賽動態——企業因為競爭對手在做同樣的事而競相訓練更大、更耗碳的模型——創造了違背效率原則的誘因。如果一家公司可以通過訓練更大、碳排放更高的模型來獲得市場份額,那麼環境成本就成了競爭優勢而非負擔。
普華永道的數據為這個問題增添了另一個維度。如果 56% 的企業從 AI 中看不到任何回報,那麼它們的算力消耗所帶來的社會成本就很難被合理化。哪怕將其中一小部分被浪費的算力重新導向真正有價值的應用,就能在不犧牲進步的前提下減少排放。
怎麼辦
AI 不會消失,它的碳足跡也不會。問題在於產業和監管機構是否會認真對待排放限制,還是繼續將成本外部化。
斯坦福的 AI 指數提供了數據。自 2021 年以來算力容量增長 30 倍,訓練排放的指數級增長,高效與低效推論之間日益擴大的差距——這些是事實,不是預測。普華永道的 CEO 調查補充了經濟背景:大部分高碳排放的投資並沒有產出回報。
技術本身提供了一些前進路徑。更小、更高效的模型——比如前沿模型蒸餾和量化版本的趨勢——可以用碳成本的一小部分提供相當的性能。產業級的算力共享,而不是每家公司維護自己的龐大基礎設施,可以減少總能源消耗。
但這些解決方案需要在一個建立在競爭之上的產業中實現協調。在激勵機制改變之前——無論通過監管、市場壓力,還是真正突破性的節能計算技術——碳排放將持續累積。30 倍的算力增長也將持續加速。
AI 產業有一個碳排放問題。它比任何人承認的都嚴重,解決它需要的不只是效率微調。它需要對構建人工智能的真實成本進行一次根本性的清算。
資料來源:斯坦福 HAI AI 指數報告 2026,IEEE Spectrum 報導;普華永道 2026 年 CEO 調查,AI Shortcut Lab 報導;Fortune 大型科技 AI 支出報導。
分享文章
留言評論
0 則評論暫無評論,搶先發表你的看法吧!