從零建構 RAG 管線:Python + ChromaDB 實戰教學
完整教學如何從零開始建構一個可運作的 RAG(檢索增強生成)管線,從文件載入、向量化、檢索到最終生成,每一步都有可運行的程式碼。
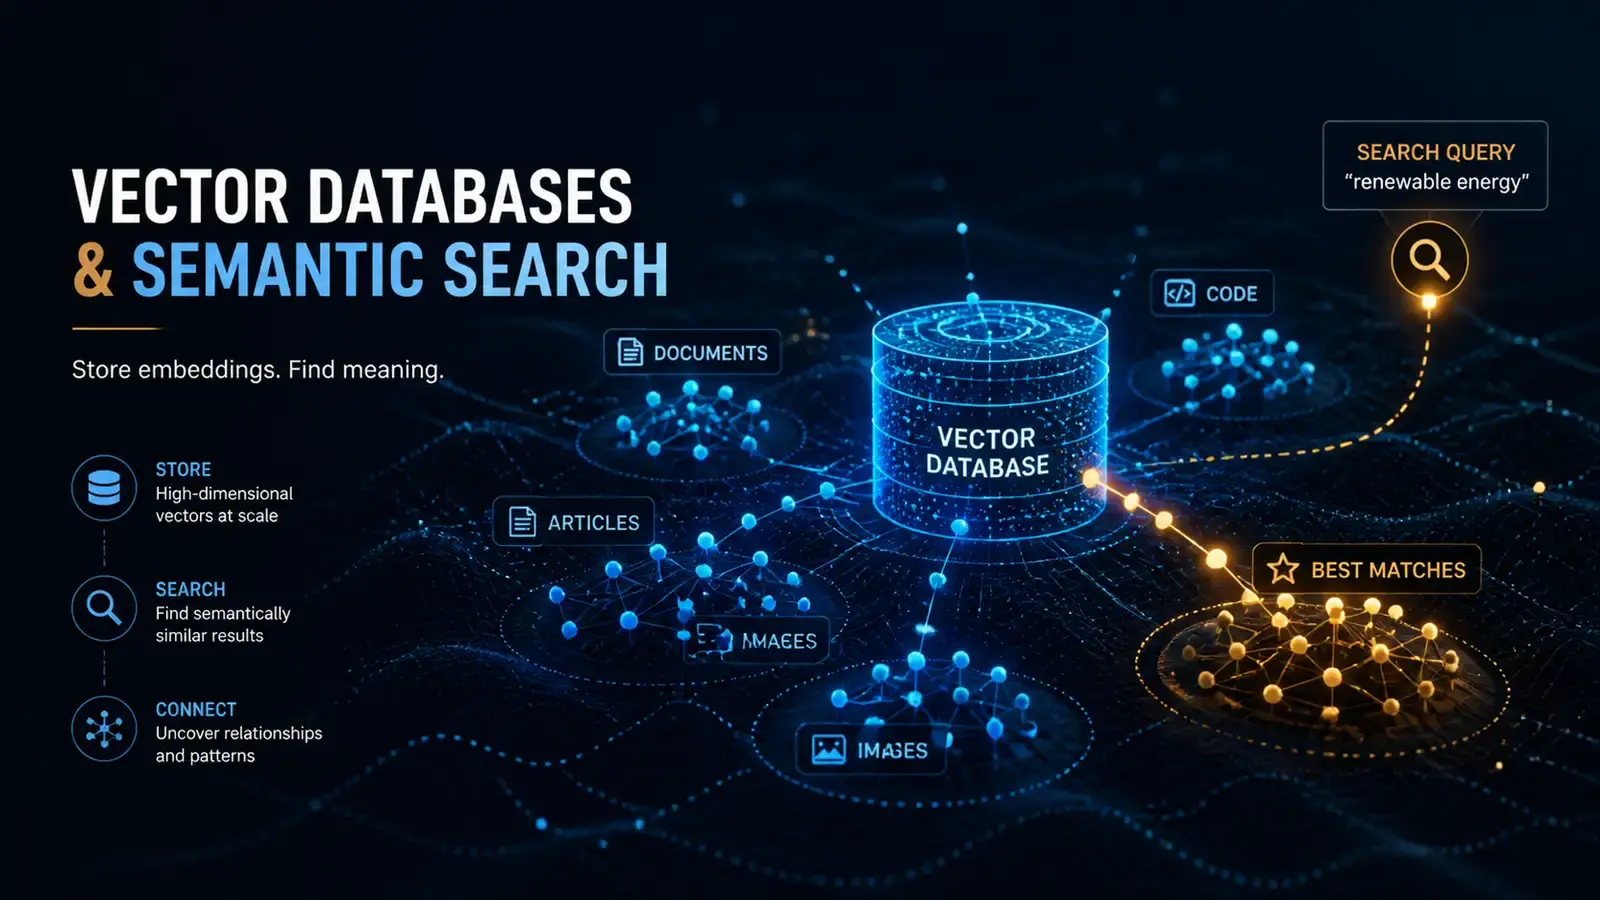
大多數 RAG 教程只教你呼叫 API,然後跳到「就這樣完成了」。但真正有用的 RAG 管線需要理解每個環節的運作原理:文件如何被切分、向量如何生成、檢索如何匹配、上下文如何注入提示詞。這篇教學會帶你從零建構一個完整的 RAG 管線,每一步都有可運行的程式碼和解釋。
為什麼需要 RAG
大型語言模型有兩個根本限制:它們的知識有截止日期,而且它們無法存取你的私有資料。RAG(Retrieval-Augmented Generation,檢索增強生成)解決了這兩個問題。它的工作原理很簡單:在模型回答問題之前,先從你的資料來源中找出相關內容,然後把這些內容作為上下文提供給模型。
這樣做的好處是雙重的。首先,模型的回答基於真實資料而非記憶,減少了幻覺。其次,你可以隨時更新資料來源而不需要重新訓練模型。根據 Anthropic 的研究,RAG 是目前減少 LLM 幻覺最有效的方法之一。
環境設置
開始之前,你需要 Python 3.10 以上版本。安裝所需套件:
pip install chromadb openai langchain langchain-community tiktokenChromaDB 是我們的向量資料庫,它輕量、不需要額外服務,非常適合快速原型開發。OpenAI 用於生成嵌入向量和最終回答。LangChain 提供文件切分和管線編排的工具。
第一步:載入文件
RAG 管線的第一步是把你的資料載入系統。支援的格式包括純文字、Markdown、PDF 等。我們從最簡單的純文字開始:
from langchain_community.document_loaders import TextLoader, DirectoryLoader

# 載入單一檔案
loader = TextLoader("knowledge_base/article1.txt")
documents = loader.load()

# 或載入整個目錄
loader = DirectoryLoader("./knowledge_base/", glob="**/*.txt")
documents = loader.load()

print(f"載入了 {len(documents)} 個文件")
每個 Document 物件包含兩個主要屬性:page_content(文件內容)和 metadata(來源資訊、頁碼等)。這些中繼資料在後續檢索結果中非常有用,可以幫助使用者確認答案的來源。
第二步:切分文件
語言模型的上下文窗口有限,而且把整份文件塞進提示詞通常效果也不好。你需要把文件切成適當大小的區塊(chunks)。切分策略直接影響檢索品質。
from langchain.text_splitter import RecursiveCharacterTextSplitter

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,        # 每個區塊的最大字元數
    chunk_overlap=50,      # 區塊之間的重疊字元數
    length_function=len,
    separators=["\n\n", "\n", "。", "!", "?", ",", " "]
)

chunks = text_splitter.split_documents(documents)
print(f"切成 {len(chunks)} 個區塊")
chunk_size 設為 500 是一個合理的起點。太小會失去上下文,太大會引入不相關的資訊。chunk_overlap 設為 50 確保切分點附近的內容不會丟失。中文字元用中文標點符號作為分隔符,確保切分位置自然。
第三步:生成嵌入向量
嵌入向量(embeddings)是把文字轉換成數字表示的過程,讓我們可以用數學方式計算文字之間的相似度。
import chromadb
from chromadb.utils import embedding_functions

# 使用 ChromaDB 內建的嵌入函數(基於 sentence-transformers)
ef = embedding_functions.DefaultEmbeddingFunction()

# 建立或連接向量資料庫
client = chromadb.PersistentClient(path="./chroma_db")
collection = client.get_or_create_collection(
    name="knowledge_base",
    embedding_function=ef
)

# 把區塊加入資料庫
texts = [chunk.page_content for chunk in chunks]
metadatas = [chunk.metadata for chunk in chunks]
ids = [f"chunk_{i}" for i in range(len(chunks))]

collection.add(
    documents=texts,
    metadatas=metadatas,
    ids=ids
)

print(f"已索引 {collection.count()} 個區塊")
ChromaDB 的 DefaultEmbeddingFunction 使用 all-MiniLM-L6-v2 模型,這是免費的本機嵌入模型,不需要 API 金鑰。對於需要更高品質嵌入的場景,可以替換為 OpenAI 的 text-embedding-3-small 模型。
第四步:檢索相關內容
當使用者提出問題時,系統需要從向量資料庫中找出最相關的區塊。這是 RAG 管線的核心環節。
def retrieve(query: str, n_results: int = 3) -> list:
    """根據查詢檢索最相關的區塊"""
    results = collection.query(
        query_texts=[query],
        n_results=n_results
    )

    retrieved = []
    for i, doc in enumerate(results["documents"][0]):
        metadata = results["metadatas"][0][i]
        distance = results["distances"][0][i]
        retrieved.append({
            "content": doc,
            "source": metadata.get("source", "未知"),
            "relevance_score": 1 - distance  # 轉換為相似度分數
        })

    return retrieved

# 測試檢索
results = retrieve("什麼是 RAG?")
for r in results:
    print(f"[{r['relevance_score']:.3f}] {r['source']}")
    print(f"  {r['content'][:100]}...")
print()檢索結果會返回最相似的區塊及其來源資訊。relevance_score 接近 1 表示高度相關,接近 0 表示不太相關。實務上建議只使用分數 > 0.7 的結果。
第五步:生成回答
最後一步是把檢索到的內容注入提示詞,讓 LLM 基於這些上下文生成回答。
from openai import OpenAI

client = OpenAI()

def rag_answer(query: str, n_results: int = 3) -> dict:
    """RAG 管線:檢索 + 生成"""
    # 檢索
    contexts = retrieve(query, n_results)

    # 組裝上下文
    context_text = "\n\n---\n\n".join([
        f"來源:{c['source']}\n內容:{c['content']}"
        for c in contexts
    ])

    # 生成回答
    response = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {
                "role": "system",
                "content": """你是知識助手。根據提供的上下文回答問題。
如果上下文中沒有相關資訊,明確說「根據現有資料無法回答」。
回答時引用來源。"""
            },
            {
                "role": "user",
                "content": f"""上下文:
{context_text}

問題:{query}"""
            }
        ],
        temperature=0.3
    )

    return {
        "answer": response.choices[0].message.content,
        "sources": [c["source"] for c in contexts]
    }

# 測試
result = rag_answer("RAG 的工作原理是什麼?")
print(result["answer"])
print(f"\n來源:{result['sources']}")
temperature 設為 0.3 是為了讓回答更穩定、更基於事實。對於創意寫作等場景,可以提高這個值。
第六步:評估與優化
建好管線只是第一步。真正的挑戰是讓它持續運作良好。幾個關鍵指標:
- 檢索精確率:檢索到的區塊中,有多少比例與問題相關?目標 > 80%。
- 回答忠實度:回答是否基於檢索到的內容?還是模型自己編造的?
- 回應時間:從查詢到回答的延遲。目標 < 3 秒。
# 簡單的評估腳本
test_queries = [
    "什麼是 RAG?",
    "向量資料庫如何工作?",
    "文件切分的最佳實踐是什麼?"
]

for q in test_queries:
    result = rag_answer(q)
    print(f"Q: {q}")
    print(f"A: {result['answer'][:200]}...")
    print(f"Sources: {result['sources']}")
    print("---")
常見的優化方向包括:調整 chunk_size、嘗試不同的嵌入模型、增加 reranking 步驟、以及改進提示詞模板。
完整程式碼
把所有步驟組合在一起,完整的 RAG 管線大約 100 行程式碼。你可以把它封裝成一個類別,方便在不同專案中重用:
class SimpleRAG:
    def __init__(self, db_path="./chroma_db", collection_name="knowledge_base"):
        self.client = chromadb.PersistentClient(path=db_path)
        self.ef = embedding_functions.DefaultEmbeddingFunction()
        self.collection = self.client.get_or_create_collection(
            name=collection_name,
            embedding_function=self.ef
        )

    def ingest(self, documents):
        """載入並索引文件"""
        splitter = RecursiveCharacterTextSplitter(
            chunk_size=500, chunk_overlap=50,
            separators=["\n\n", "\n", "。", "!", "?", ",", " "]
        )
        chunks = splitter.split_documents(documents)

        self.collection.add(
            documents=[c.page_content for c in chunks],
            metadatas=[c.metadata for c in chunks],
            ids=[f"chunk_{i}" for i in range(len(chunks))]
        )
        return len(chunks)

    def query(self, question, n_results=3):
        """查詢並生成回答"""
        results = self.collection.query(
            query_texts=[question], n_results=n_results
        )
        contexts = results["documents"][0]
        sources = [m.get("source", "") for m in results["metadatas"][0]]

        context_text = "\n\n".join(contexts)
        response = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[
                {"role": "system", "content": "根據上下文回答問題,引用來源。"},
                {"role": "user", "content": f"上下文:\n{context_text}\n\n問題:{question}"}
            ],
            temperature=0.3
        )
        return response.choices[0].message.content
下一步
這篇教學建立了一個功能完整的 RAG 管線,但它只是起點。進階方向包括:
- 混合檢索:結合關鍵字搜尋(BM25)和語義搜尋,提升檢索品質
- Reranking:用 Cross-Encoder 模型對檢索結果重新排序
- 多模態 RAG:支援圖片、表格等非文字內容的檢索
- 對話式 RAG:支援多輪對話,記住之前的上下文
RAG 技術還在快速演進。掌握這些基礎概念後,你就能跟上這個領域的最新發展,並根據自己的需求構建更複雜的系統。
分享文章
留言評論
0 則評論暫無評論,搶先發表你的看法吧!
相關文章
審查 AI 生成程式碼的 5 項安全檢查:你的 Copilot 不會替你做的事
Veracode 2026 年報告指出,AI 生成的程式碼安全檢查通過率僅 56%。這份清單幫你抓到 Copilot 和 Cursor 漏掉的漏洞。
你正在被 AI 編碼助手養廢——以下是自救指南
AI 編碼工具幫你省下寫 boilerplate 的時間,但也偷偷吃掉你最重要的能力:獨立思考程式碼的能力。一套經過實戰驗證的工作流程,讓你用 AI 而不被 AI 用。
Claude Code 自動化實戰:用 Hooks、Skills 與 MCP 打造自己的 AI 開發工作流
深入 Claude Code 最被低估的三大功能——事件鉤子(Hooks)、自訂技能(Skills)與 MCP 整合——教你如何讓 AI 編碼助手從「對話工具」升級為自動化開發夥伴,附完整設定範例。