Z-Image Turbo 解析:阿里巴巴 6B 開源圖像模型、8 步生成與使用限制
解析阿里巴巴通義 Tongyi-MAI 團隊的 Z-Image Turbo:6B 參數 S3-DiT 架構、Decoupled-DMD 蒸餾、用 diffusers 執行的方法、適用場景與限制,內容依據官方模型卡與技術報告。
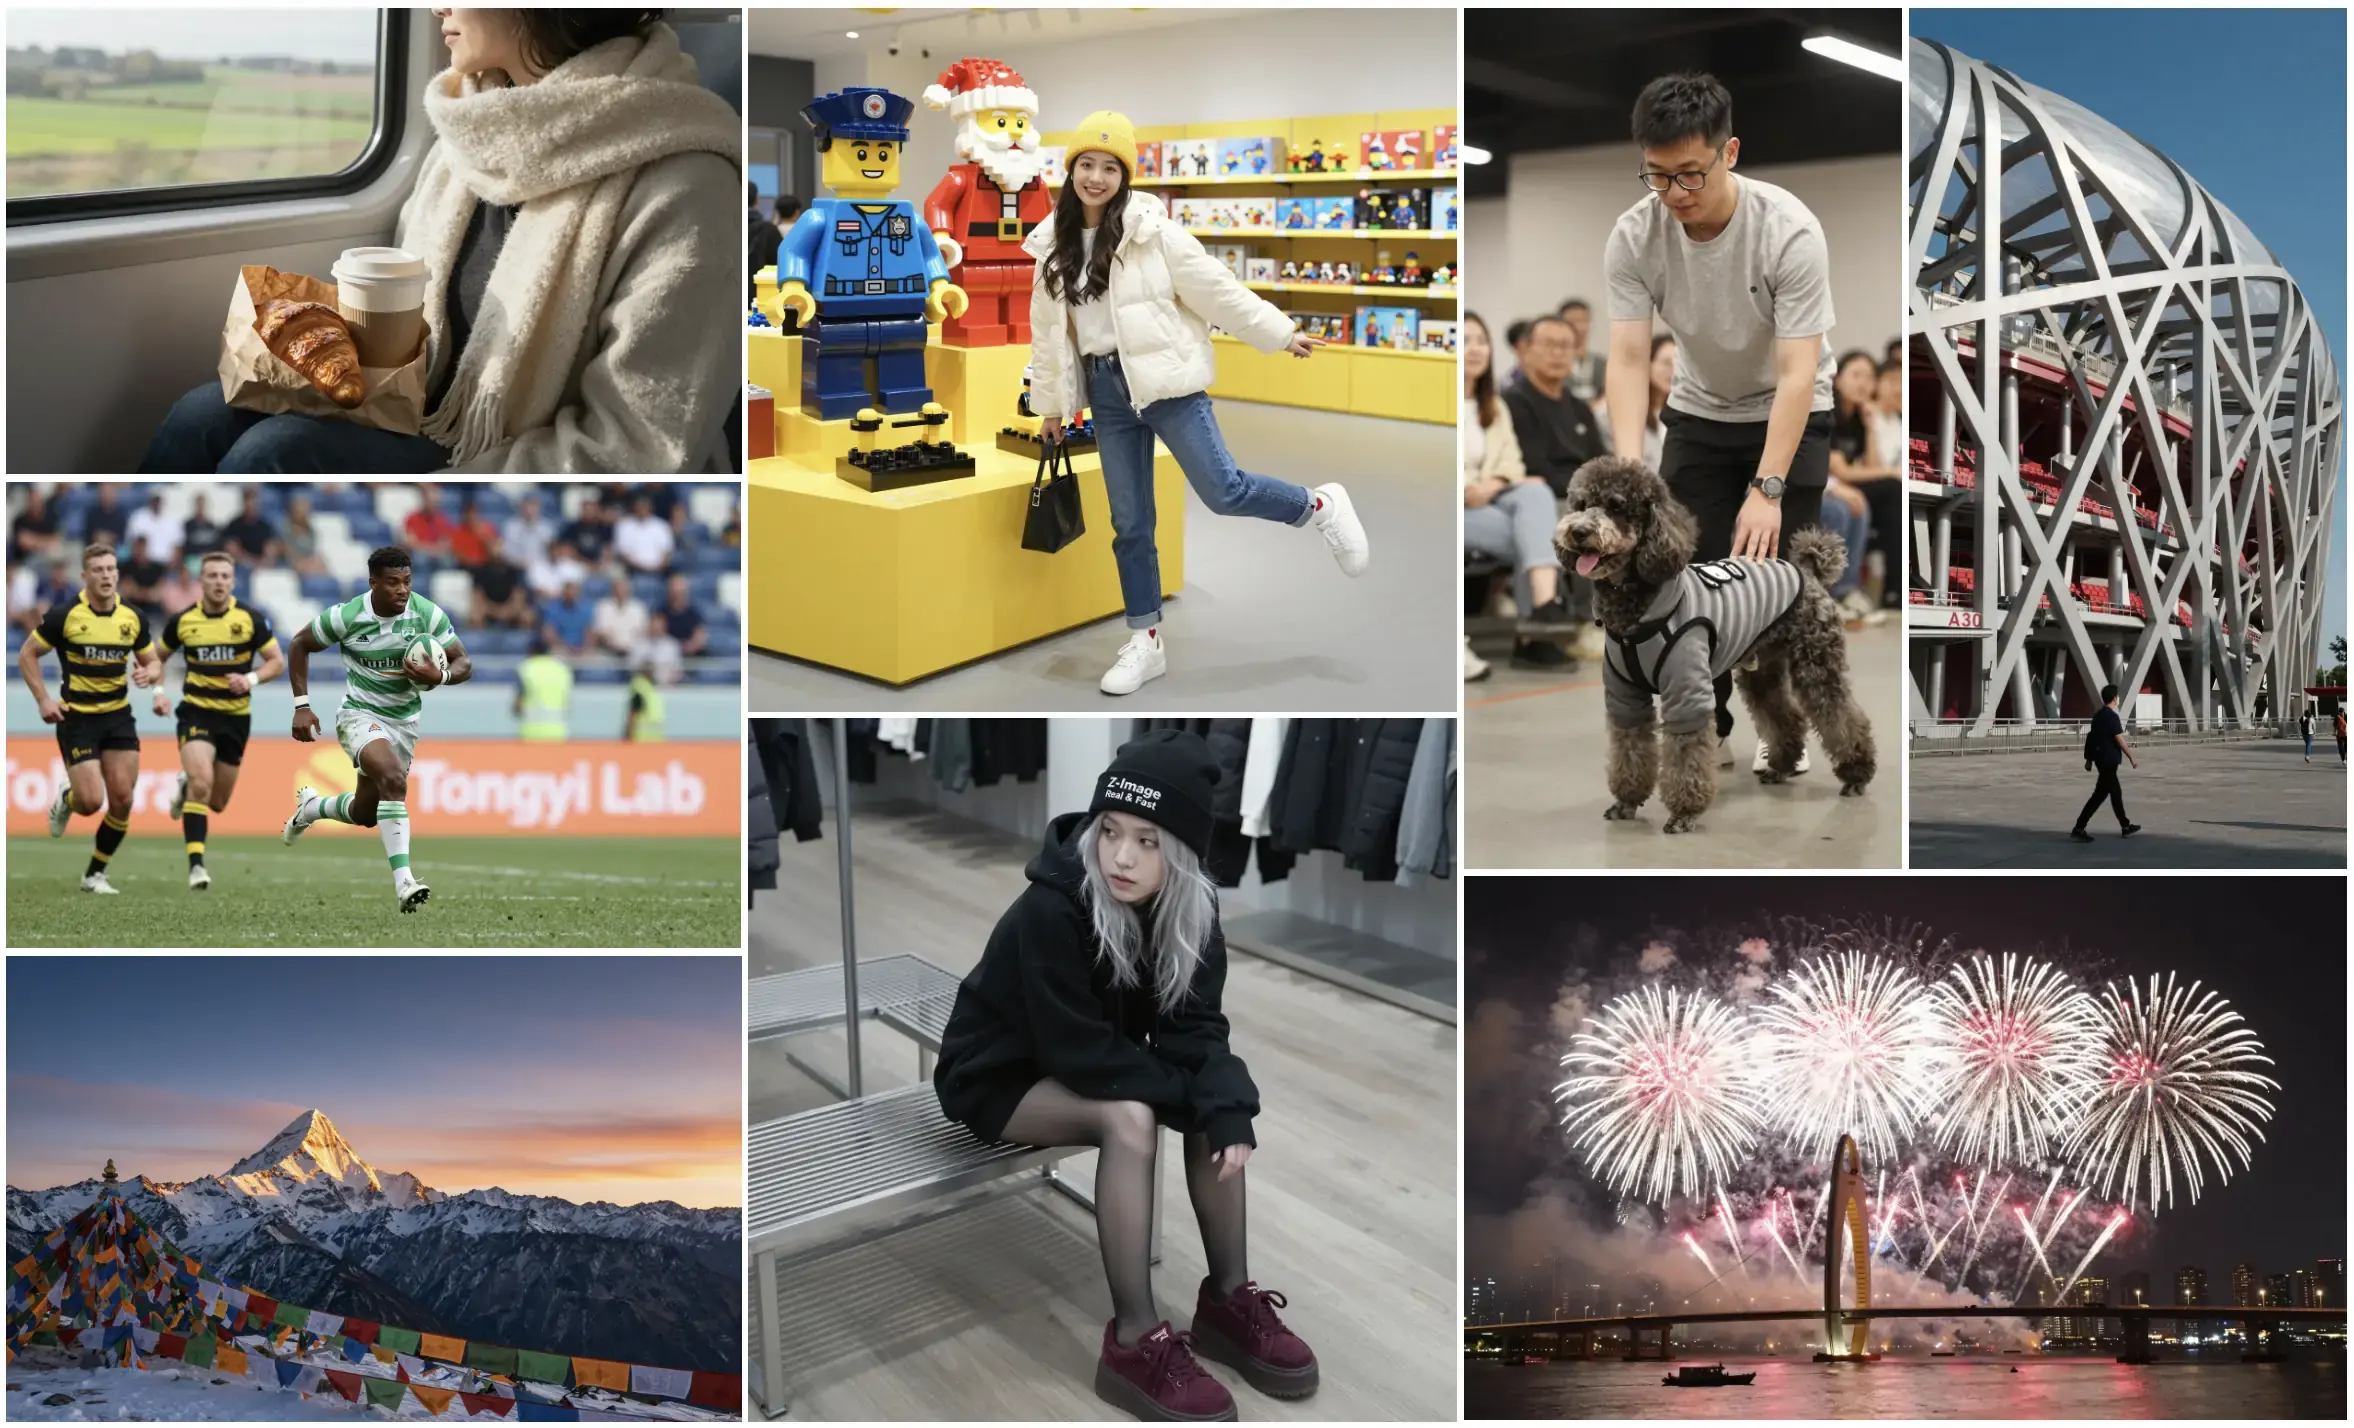
開源圖像模型越做越大:Black Forest Labs 的 FLUX.2 [dev] 有 320 億參數,騰訊的 HunyuanImage 3.0 則是 800 億參數的混合專家模型。阿里巴巴通義 Tongyi-MAI 團隊推出的 Z-Image 走相反路線:只有 60 億(6B)參數,目標是在消費級顯示卡上執行。其中速度最快的 Z-Image-Turbo 只需 8 步就能生成一張圖。本文根據官方模型卡與技術報告,整理它是什麼、如何運作、怎麼使用,以及有哪些限制。
Z-Image 家族
根據 Hugging Face 模型卡,Z-Image 目前有四個版本,皆為 6B 參數:
| 版本 | 步數 | CFG | 任務 | 模型卡說明 |
|---|---|---|---|---|
| Z-Image-Turbo | 8 | 否 | 生成 | 蒸餾版,畫質評為「很高」,多樣性低 |
| Z-Image | 50 | 是 | 生成 | 基礎模型,多樣性較好,適合微調 |
| Z-Image-Omni-Base | 50 | 是 | 生成與編輯 | 供社群微調的原始底模 |
| Z-Image-Edit | 50 | 是 | 編輯 | 依自然語言指令進行圖生圖 |
權重以 Apache 2.0 授權釋出,允許商業使用。模型卡撰寫時 Omni-Base 與 Edit 仍標示「即將釋出」,實際狀況請以模型卡為準。
官方宣稱的能力
團隊對 Z-Image-Turbo 的描述包括:
- 在企業級 H800 GPU 上可達次秒級生成,並可在 16 GB 顯存的消費級設備上執行。
- 寫實照片風格的生成品質。
- 中英雙語文字渲染,這是許多圖像模型的弱項。
- 良好的指令遵循,並可搭配會「推理」的提示詞增強器擴寫簡短提示。
效能方面,模型卡引用阿里巴巴 AI Arena 排行榜的 Elo 人類偏好評測,稱 Turbo 可與領先模型競爭,並在開源模型中達到最佳水準。不過該排行榜由阿里巴巴自行營運,下結論前最好再參考獨立評測。
技術原理
S3-DiT 架構
Z-Image 採用可擴展單流擴散 Transformer(S3-DiT):把文字 token、視覺語意 token 與圖像 VAE token 在序列層級串接成單一輸入流處理;雙流架構則為文字與圖像各自保留一套權重。團隊認為單流設計的參數效率更高,這是 6B 模型能與大模型競爭的關鍵。細節見技術報告。
Decoupled-DMD 蒸餾
Turbo 的 8 步速度來自蒸餾。Decoupled-DMD 論文指出,分佈匹配蒸餾(DMD)其實由兩個機制共同作用:CFG 增強是主要驅動力,分佈匹配則扮演正則化角色。把兩者拆開後即可分別最佳化。之後的 DMDR 再把蒸餾與強化學習結合,以提升語意對齊與美感。
實際影響是:Turbo 設計為不使用無分類器引導(CFG),官方範例將 guidance_scale 設為 0,因此負面提示詞幾乎沒有作用。若你依賴負面提示詞,應改用基礎版 Z-Image。
如何使用
透過 diffusers
Z-Image 已併入 Hugging Face diffusers。模型卡範例如下:
import torch
from diffusers import ZImagePipeline

pipe = ZImagePipeline.from_pretrained(
    "Tongyi-MAI/Z-Image-Turbo", torch_dtype=torch.bfloat16)
pipe.to("cuda")
# pipe.enable_model_cpu_offload()  # 顯存不足時使用

image = pipe(prompt="夜市街道,霓虹招牌寫著繁體中文",
             height=1024, width=1024,
             num_inference_steps=9,   # 實際為 8 次 DiT 前向運算
             guidance_scale=0.0).images[0]
image.save("example.png")
注意步數:範例設定 num_inference_steps=9,模型卡說明實際只會執行 8 次 DiT 前向運算。開啟 CPU 卸載可降低顯存需求,但速度會變慢;支援的硬體可啟用 Flash Attention 或 torch.compile 加速。
透過 ComfyUI 或線上試用
ComfyUI 已可用標準工作流程載入 Z-Image。若想先試試提示詞效果,模型卡也連結了 Hugging Face Spaces 與 ModelScope 的線上展示。
適用場景
- 雙語行銷與電商素材:招牌、包裝、海報上的中文需要清楚可讀。
- 快速發想:單張消費級顯示卡即可,8 步生成讓反覆嘗試很快。
- 微調專案:應使用基礎版 Z-Image,模型卡將 Turbo 的可微調性標為不適用。
限制
- Turbo 多樣性低:模型卡自己也這麼評價,同一提示詞的結果容易相似,需要變化時改用基礎版。
- 不支援 CFG:負面提示詞與引導強度調整不在 Turbo 的工作流程中。
- 編輯需另一個模型:Turbo 只做文生圖。
- 文字渲染好但非完美:複雜或較長的字串仍可能出錯,發布前務必檢查。
- 負責任使用:與其他寫實模型一樣,它可能生成與真人相似的圖像。未經同意不要生成真實人物的肖像,並遵守授權條款與當地法規。
結論
Z-Image-Turbo 證明,透過架構設計與蒸餾,6B 模型也能與更大的開源模型同台比較,同時能在 16 GB 消費級顯示卡上執行。它的長處是速度與雙語文字,代價是多樣性低、不支援引導。對多數使用者而言,實際做法是用 Turbo 快速出草稿,需要多樣性或微調時改用基礎版 Z-Image。
參考資料
讀者回應与討論
暫無讀者回應,歡迎發表你的見解。
相關文章
FLUX.2 Klein 深度評測:4 秒出圖、文生圖與編輯合一的開源新王炸
Black Forest Labs 發布 FLUX.2 Klein 系列模型,號稱「開源界的速度之王」。本文介紹 4B/9B 版本的定位與上手方式,並說明與 Qwen Image Edit 2511 該比較哪些面向,告訴你為什麼它是電商修圖的首選。
AIGC 是什么?用一张「套娃图」讲清 AI、机器学习、深度学习、生成式 AI 与 LLM
别再被术语绕晕:用最直白的方式把 AIGC/生成式 AI、AI、机器学习、深度学习、大语言模型的关系一次捋顺,并给出选择工具与避坑的实用清单。
Avataar AI 推出 Varya 影片生成模型:以模型蒸餾技術實現 10 倍加速,成本大幅降低
印度新創 Avataar AI 在印度政府 12 億美元 AI 任務計畫支持下,基於阿里巴巴開源 Wan 2.2 模型進行蒸餾優化,推出文化感知型影片生成模型 Varya,生成速度提升十倍,成本大幅降低,並開放模型權重供社群使用。